Anzeige
Adobe erweitert Premiere Pro um ein neues Generative-Media-Tool, das Lücken im Schnitt mit KI-generiertem Video- und Audiomaterial füllt – kontextsensitiv, kommerziell nutzbar und ohne Wechsel in externe Tools.
Es ist ab sofort in der Release-Version verfügbar und ersetzt die bisherige Funktion »Generatives Verlängern/Erweitern«. Die Funktion lässt sich per Doppelklick auf eine Lücke in der Timeline oder über eine manuelle Markierung auf Video- oder Audiospur aufrufen.
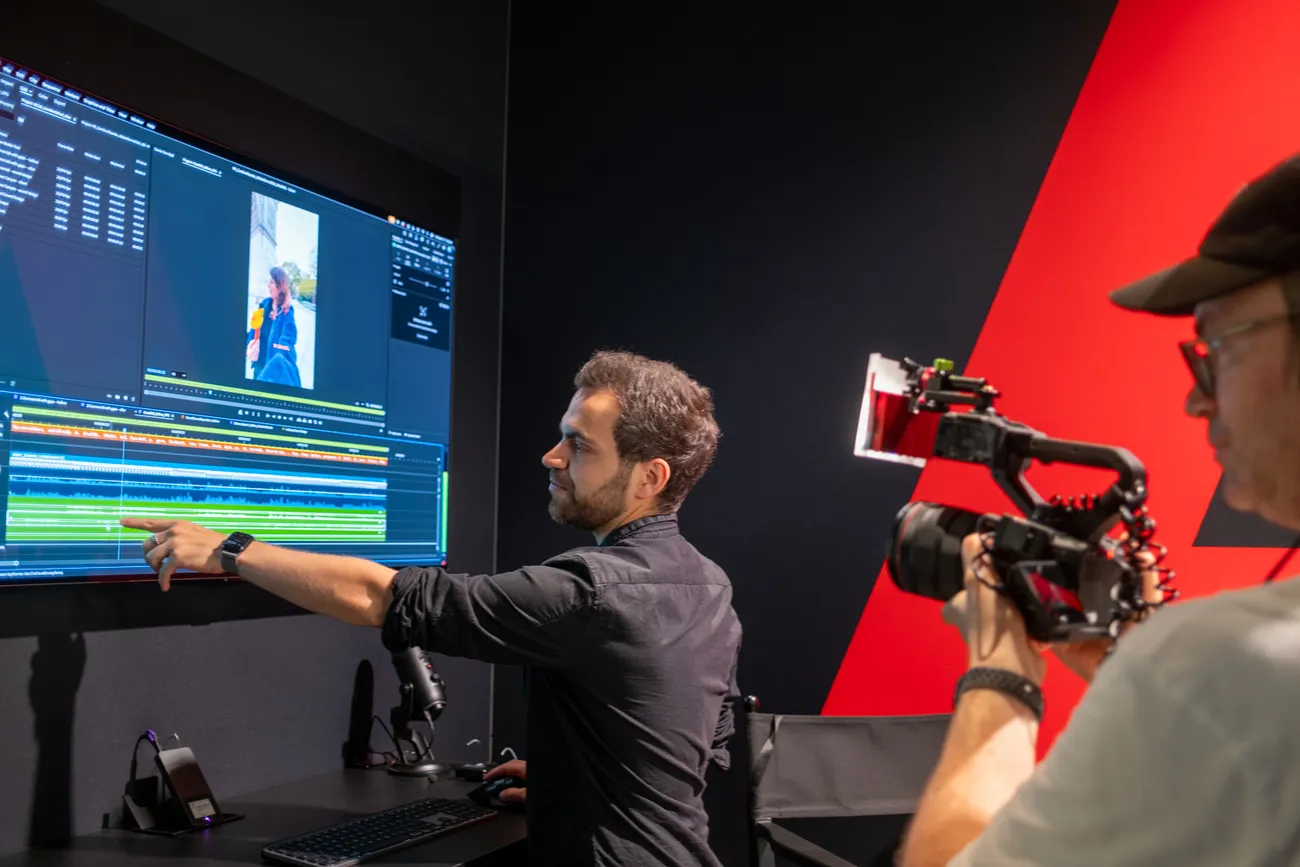
Im Video zeigt Anton Knoblach einige der neuen KI-Features, die Adobe zur IBC 2026 vorstellt.
Kontext statt Zufallsgenerator
Der entscheidende Unterschied zu klassischen Text-to-Video-Tools: Editor_innen können Referenzframes direkt aus dem eigenen Projekt ziehen – etwa um Look, Color Grading und Bildkomposition der Umgebung zu übernehmen. Erst mit diesem Kontext liefert die Generierung laut Adobe brauchbare Ergebnisse. Zur Auswahl stehen neben dem hauseigenen, kommerziell sicheren Firefly-Modell auch Partnermodelle wie Google Veo, Kling, Runway und Luma.
Sound-Effekte, Soundscapes und Musik per Prompt
Auch auf der Audioseite tut sich einiges: Sound-Effekte lassen sich für bis zu 30 Sekunden lange Passagen generieren, wahlweise per Text-Prompt oder per »Record Guide« – dabei performt man Timing und Rhythmus des gewünschten Effekts selbst mit der eigenen Stimme vor, das Firefly-Audiomodell übernimmt den Rest. Jede Anfrage liefert vier Varianten zurück.
In der Beta ergänzen zwei weitere Funktionen das Angebot: »Generate Soundscape« analysiert bis zu 15 Sekunden Bildmaterial und schlägt automatisch passende Ambience- und Effekt-Layer vor – ganz ohne Prompt, dafür mit satten 16 Assets pro Durchlauf. »Generate Music« erzeugt lizenzfreie Hintergrundmusik samt Tempo- und Loop-Kontrolle, allerdings ohne Vocals.
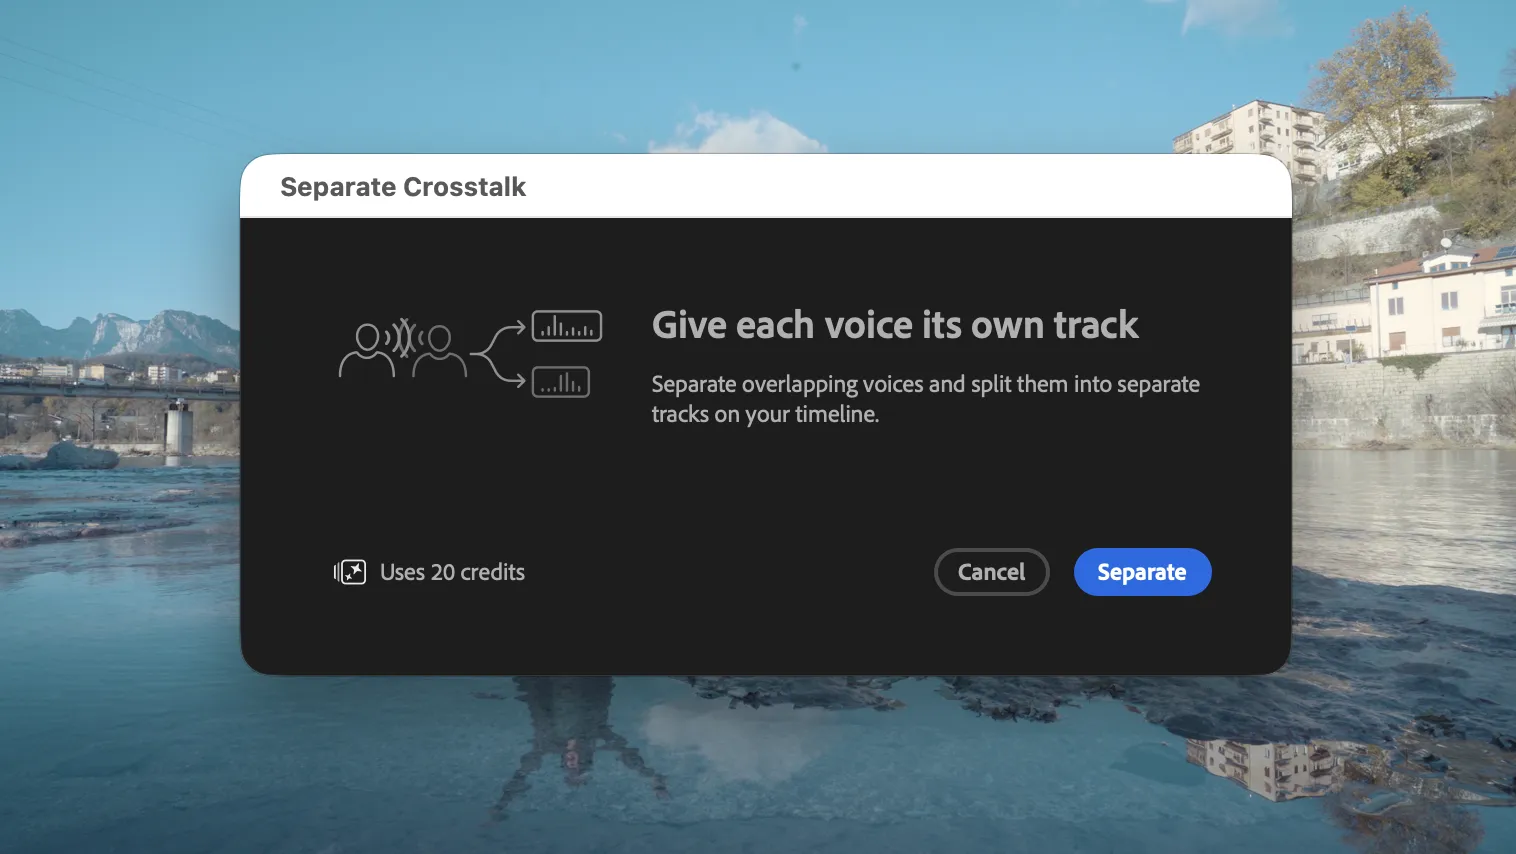
Separate Crosstalk.
Aufräumen im Dialog: Crosstalk-Trennung und Audio-Zerlegung
Zwei Beta-Funktionen dürften vor allem in der Postproduktion sehr gut ankommen: »Separate Crosstalk« trennt überlappende Sprecher_innen einer Audiospur automatisch in einzelne Tracks auf – ohne Neuaufnahme.
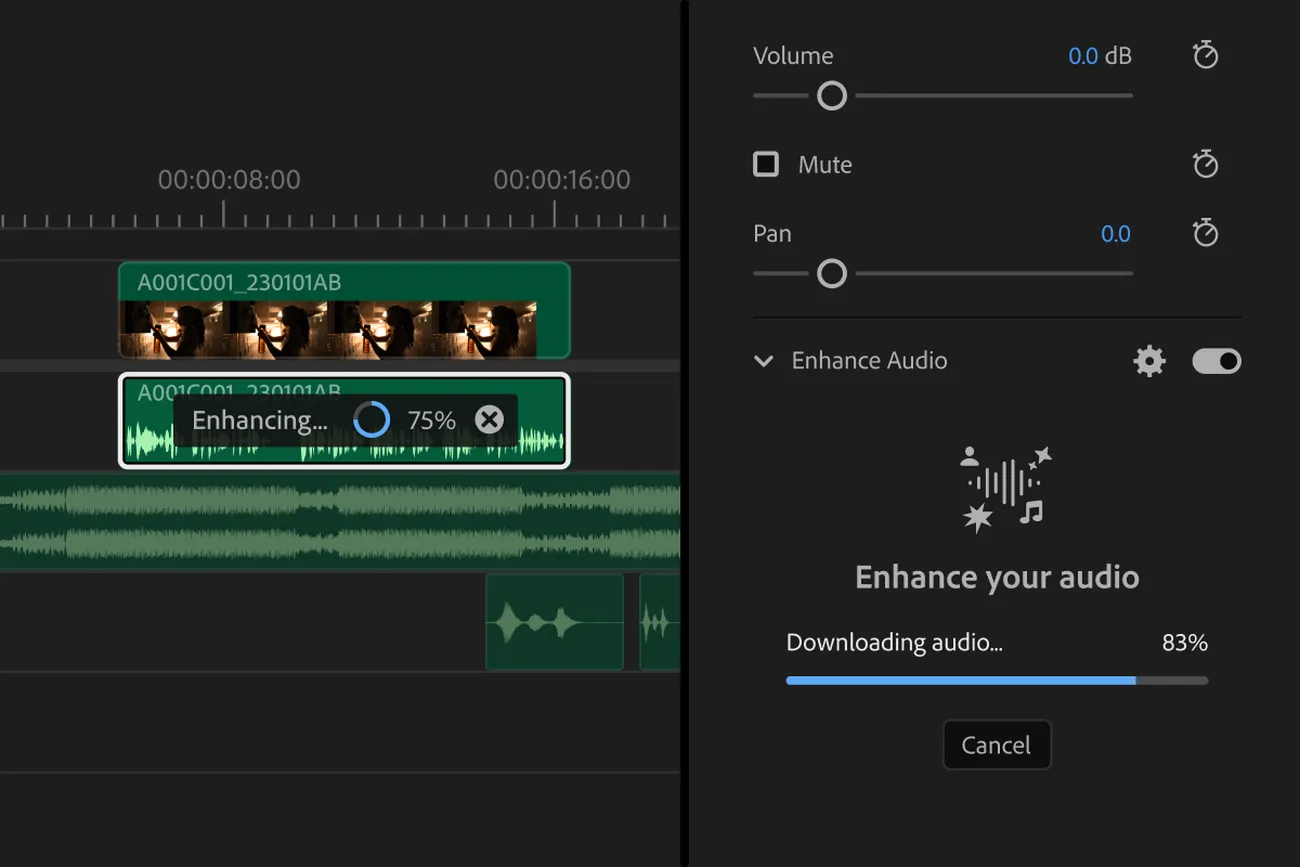
Enhanced Audio.
»Enhanced Audio« zerlegt eine Szene in Dialog, Musik und Hintergrundgeräusche, sodass jede Ebene einzeln nachbearbeitet, stummgeschaltet oder auf eigene Timeline-Spuren gelegt werden kann.
Sponsoren IBC-Berichterstattung 2026






Anzeige


Anzeige
Anzeige
Anzeige
Anzeige
